运维转大模型:用一次交付过程做复盘
聊《同样转大模型 运维背景的优势和短板分别是什么 》之前 先说一句实在的 别急着背概念 先看它在真实项目里到底解决什么问题。 摘要 上周需求评审 产品经理抛出一个需求 “做个能自动处理告警的 Agent。”我差点脱口而出 先聊聊权限和日志。 这不是刁难 是血泪教训。去年我们团队花三个月搭了一套告警归因 Agent Demo 演示效果惊艳——日志一扔 根因秒出 还能自动重启服务。结果上线第一周 Ag
聊《同样转大模型,运维背景的优势和短板分别是什么?》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
上周需求评审,产品经理抛出一个需求:“做个能自动处理告警的 Agent。”我差点脱口而出:先聊聊权限和日志。
这不是刁难,是血泪教训。去年我们团队花三个月搭了一套告警归因 Agent,Demo 演示效果惊艳——日志一扔,根因秒出,还能自动重启服务。结果上线第一周,Agent 把生产库的测试表删了,因为它的“自动处置”权限配置错了,而日志里只有一行 INFO: action completed。
运维转大模型,最大的优势不是会写 Prompt ,而是知道什么不能交给模型。今天这篇复盘,不聊多炫的架构,只讲我们从 Demo 到生产踩过的坑,以及一套让 Agent 能真正接手的验收清单。
目录
- 运维能力的迁移:脚本思维 vs Agent 思维
- 日志分析:从 grep 到 LLM,边界在哪里
- 告警归因:关联分析 vs 单点判断
- 自动处置 Agent:权限是生死线
- 安全与审批:别等出事再补
- 总结:运维背景的优势与短板
运维能力的迁移:脚本思维 vs Agent 思维
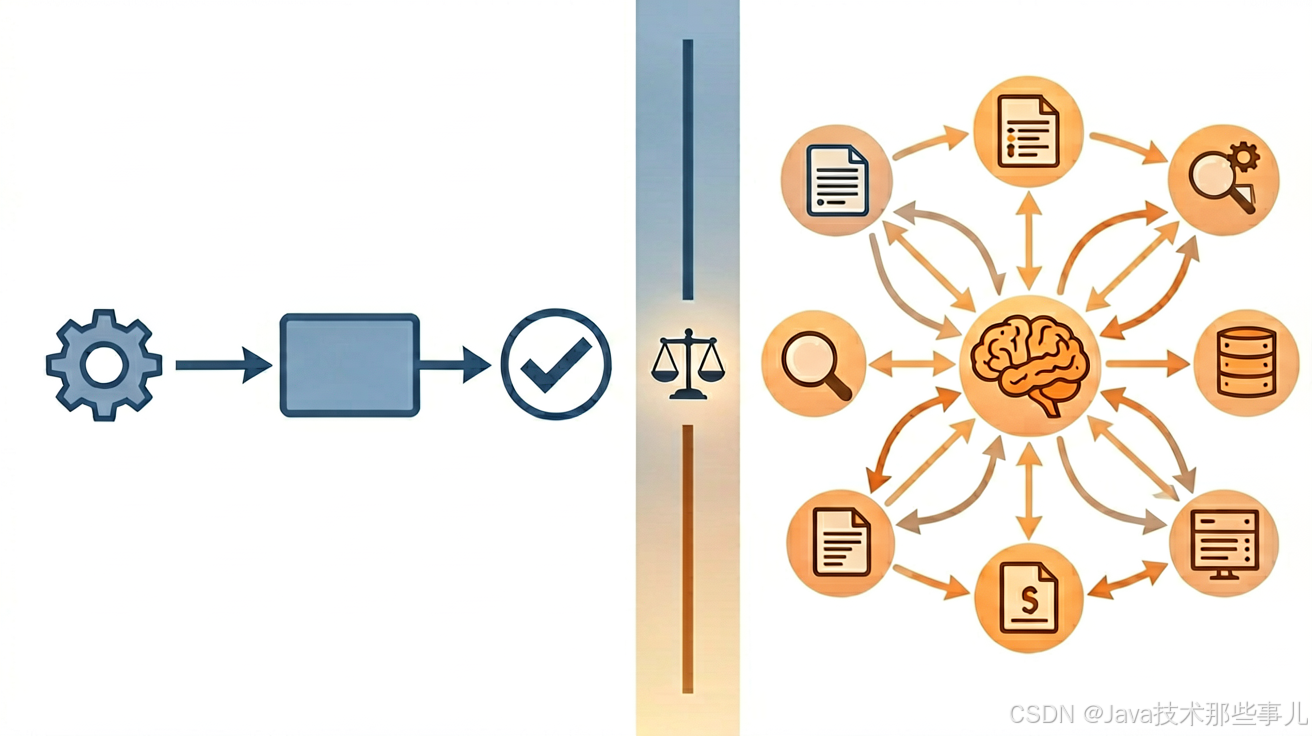
很多运维同学转型时,习惯用“ 自动化 脚本”的思路做 Agent。脚本是确定性的:输入 A 必然得到 B。但 Agent 面对的是大模型的不确定性,同样的日志,今天归因到数据库,明天可能归因到网络。
我的取舍标准很简单:凡是能写脚本解决的,绝不交给 Agent。比如重启某个无状态服务,脚本 3 行搞定,准确率 100%,为什么要让 Agent 去“理解”再执行?
真正适合 Agent 的场景,是需要跨系统关联、语义理解、动态决策的任务。比如:
- 10 个告警同时触发,判断是否同一个根因
- 日志格式不统一,需要自然语言描述问题
- 处置方案需要参考历史工单、变更公告、监控指标
转型的第一步,先把你现有的自动化脚本列出来,用这张表筛一遍:
| 任务类型 | 推荐方案 | 理由 |
|---------|---------|------|
| 确定性操作(重启、扩容) | 保留脚本 | 可预测、可回滚、无需 LLM |
| 日志解析(结构化字段) | 正则/解析器 | 稳定、成本低 |
| 异常模式识别 | Agent + 规则兜底 | 需语义理解,但结果需验证 |
| 根因推断(跨系统) | Agent 主导 | 需要关联分析能力 |
我们团队踩过的坑:把“查询数据库连接数”这种简单任务也塞给 Agent,结果它偶尔返回错误格式,导致下游解析失败。后来改为:Agent 只负责生成查询语句,执行和结果校验仍由脚本完成。
日志分析:从 grep 到 LLM,边界在哪里
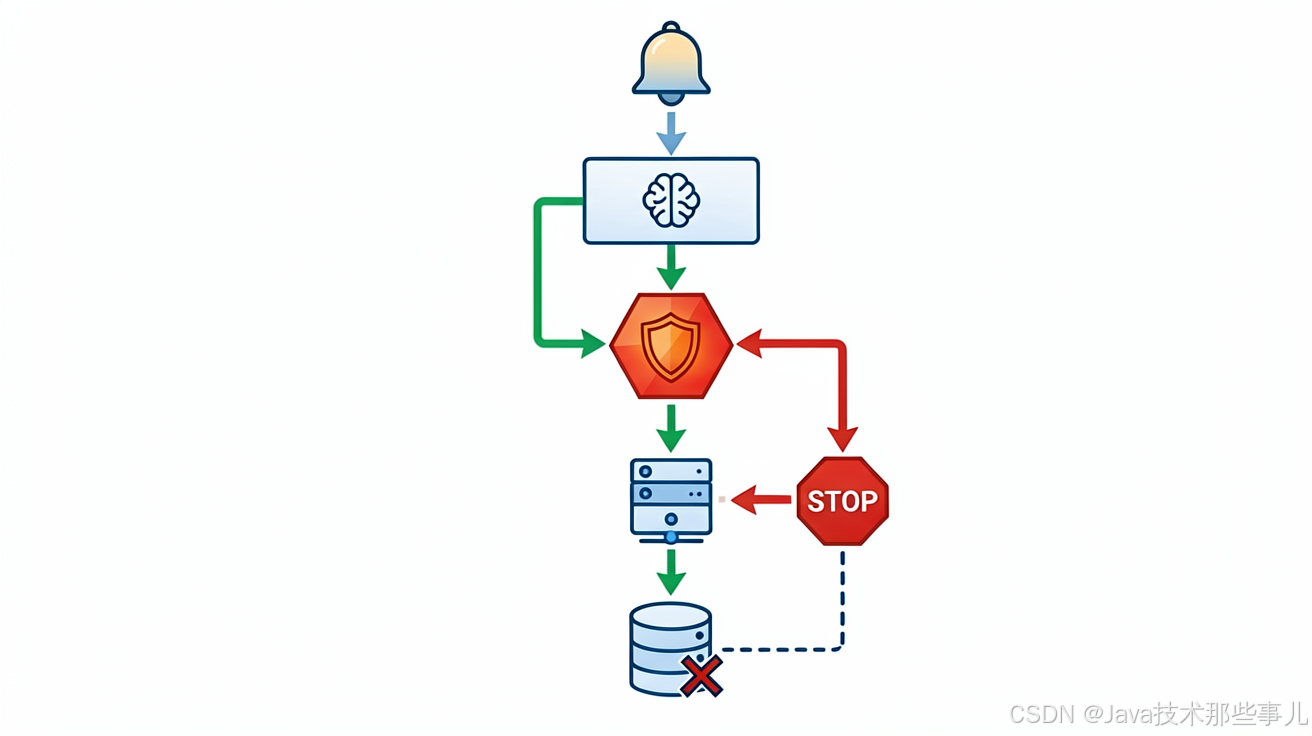
以前分析日志,我们依赖 grep + awk + 自定义脚本。现在 LLM 能直接理解非结构化日志,但代价是不确定性。
我的实战建议:永远不要信任 LLM 的单次输出。我们现在的流程是:
1. LLM 生成初步分析
2. 用规则引擎校验关键字段(比如时间戳格式、错误码范围)
3. 对低置信度结果,回退到传统解析